先给结论:无人值守的月度算薪,不是把点击动作自动化,而是四件事同时成立——任务自触发、取数带时点快照、校验能自己下判断、异常分得清该谁处理。缺一条,发薪前一周人还是得整夜盯着。
本文面向万人级制造集团的HR实施者,按"断点→4个技术条件→三条路线→落地节奏"拆开。
不少集团早就上了薪酬系统,算薪却仍是每月最重的人工活。症结不在计算,而在三处断点。
一是跑批绑人。 从考勤封账、绩效同步到算薪、报盘、工资条推送,十几个动作全靠一人按顺序点,请假线就停摆。二是失败静默。 某法人社保缴交数据没生成,任务照常往下跑,那项结果是空的,直到员工发现工资少了才倒查——传统做法靠人肉巡检,而工作流编排要求每节点有状态回执。三是难回溯。 出问题要用聊天记录和多个表格版本比对,答不出"依据哪条规则、用了哪份数据"。
三处断点指向一件事:门槛不在计算,而在运行态的可观测性——缺的是让系统在无人看管时也能判断"该不该往下走"。
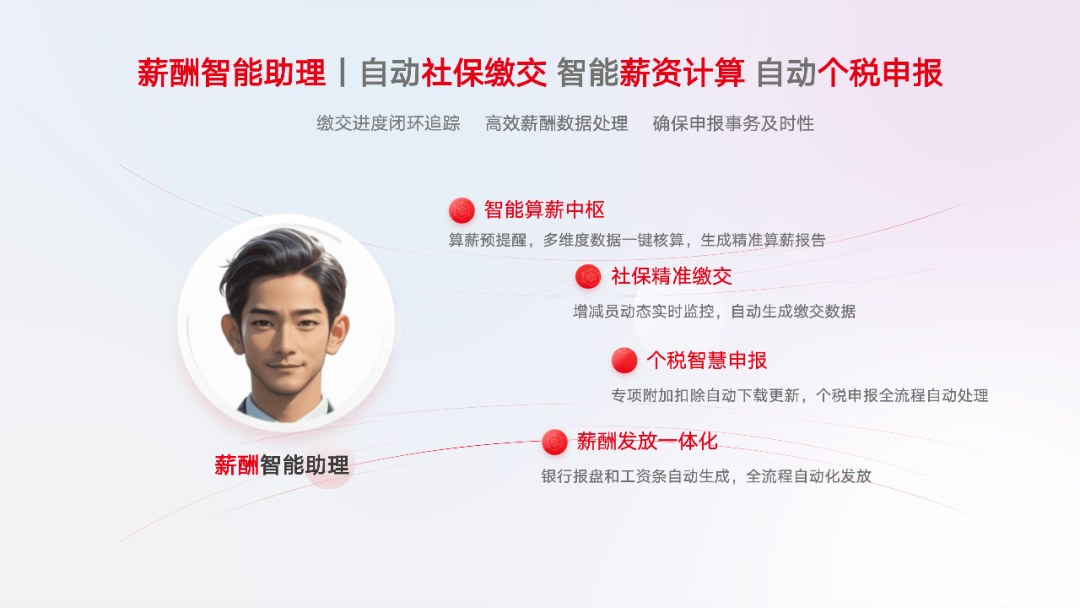
图1:薪酬作业自动化的四个执行域
任务定义要比"何时点一下"更完整:触发时间、组织范围、业务月份、结果接收人,缺一不可。
触发时间不能写成单点定时。算薪的前置是考勤封账与绩效锁定,写死时点会踩到上游未完成的空档。正确做法是用工作流编排把链路建成有向依赖:前置节点产出回执后才释放下游,定时只管"最晚何时开始"。组织范围要按法人而非组织树,否则跨法人调动的员工会重复计入或漏计;业务月份与发薪月份要分两个字段,否则跨月补发会算错账期。
最易被忽略的是幂等键:取"法人+账期+方案+规则版本"作业务主键,同批次重复触发识别为同一笔业务,只更新不重复生成发放单。没有它,重跑一次就是双倍工资。
算薪输入有4类数据,时点与口径各异:假勤以考勤封账时点为准;绩效锁定已审批发布的版本号;社保基数按参保地当年度上下限校验;专项附加扣除按申报期从税务侧拉取后与台账比对。取数通常由数据中台统一收口,跨法人汇总还要做隐私计算与权限隔离。
基数与税率这两条口径最容易被改。缴费基数按当地上年度社会平均工资的60%至300%核定,据国务院办公厅2019年印发的《降低社会保险费率综合方案》,城镇职工基本养老保险单位缴费比例从20%降至16%。个税按国家税务总局2018年第61号公告采用累计预扣法,税率随累计应纳税所得额跳档;据国务院2023年发布的专项附加扣除标准调整通知,扣除口径从6项扩为7项。口径同时变动,若只存结果值而无参数快照,事后无法解释某人扣款为何变。
取数产物不是数字,而是带时点与版本的结构化快照:来源系统、抽取时间戳、业务截止时点、规则版本号。
人工核对靠人,是因为判断长在经验里。要让系统自己下判断,就得把经验写成断言——每条只输出通过或不通过,而非等人解读的数字。
一致性断言解决"人不对":社保参保名单与在职名单比对,增减员差异逐人列出;发放名单与银行账户台账比对,账户异常直接拦下。按《社会保险法》第五十八条,用工之日起30日内应办理社保登记。
边界断言解决"数不对":缴费基数是否落在当年度上下限、个税累计额是否出现负值、实发是否低于当地最低工资线。
异常分布断言解决"结构不对":同一岗位序列内实发金额是否出现离群点。要权衡准确率与召回率:阈值紧则漏报,松则误报。
笼统的"失败重试"会把可恢复问题与必须人工决策的问题混在一起。数据类可自动恢复:接口超时、格式不符不需要业务判断,策略是带退避的重试,用尽后挂起并通知责任人,恢复后从断点续跑。规则类必须挂起:基数超限、离职员工出现在发放名单,涉及业务事实,系统无权自决。外部接口类要能降级:微服务架构下经 API 网关统一收口的重试与熔断,比各模块各写一套更可控;多法人再叠加分布式执行。
一条硬边界:回滚只能停在报盘之前。资金流出后能做的是冲正单据走审批,不是撤销重算。
| 实现方式 | 核心能力 | 数据覆盖 | 落地周期 | 维护成本 | 适配规模 |
|---|---|---|---|---|---|
| 自建脚本定时跑批 | 能算不能查 | 仅本系统 | 2至4周 | 人员变动即失效 | 单法人、千人以下 |
| RPA模拟人工操作 | 跨系统点击 | 有界面的系统 | 4至8周 | 页面改版即断 | 不便改造时过渡 |
| 平台内置任务编排 | 调度校验审计一体 | 假勤绩效社保个税同源 | 6至12周 | 规则可低代码配置 | 多法人万人级集团 |
三条路线的差别不在自动化程度,而在异常之后谁来收场。
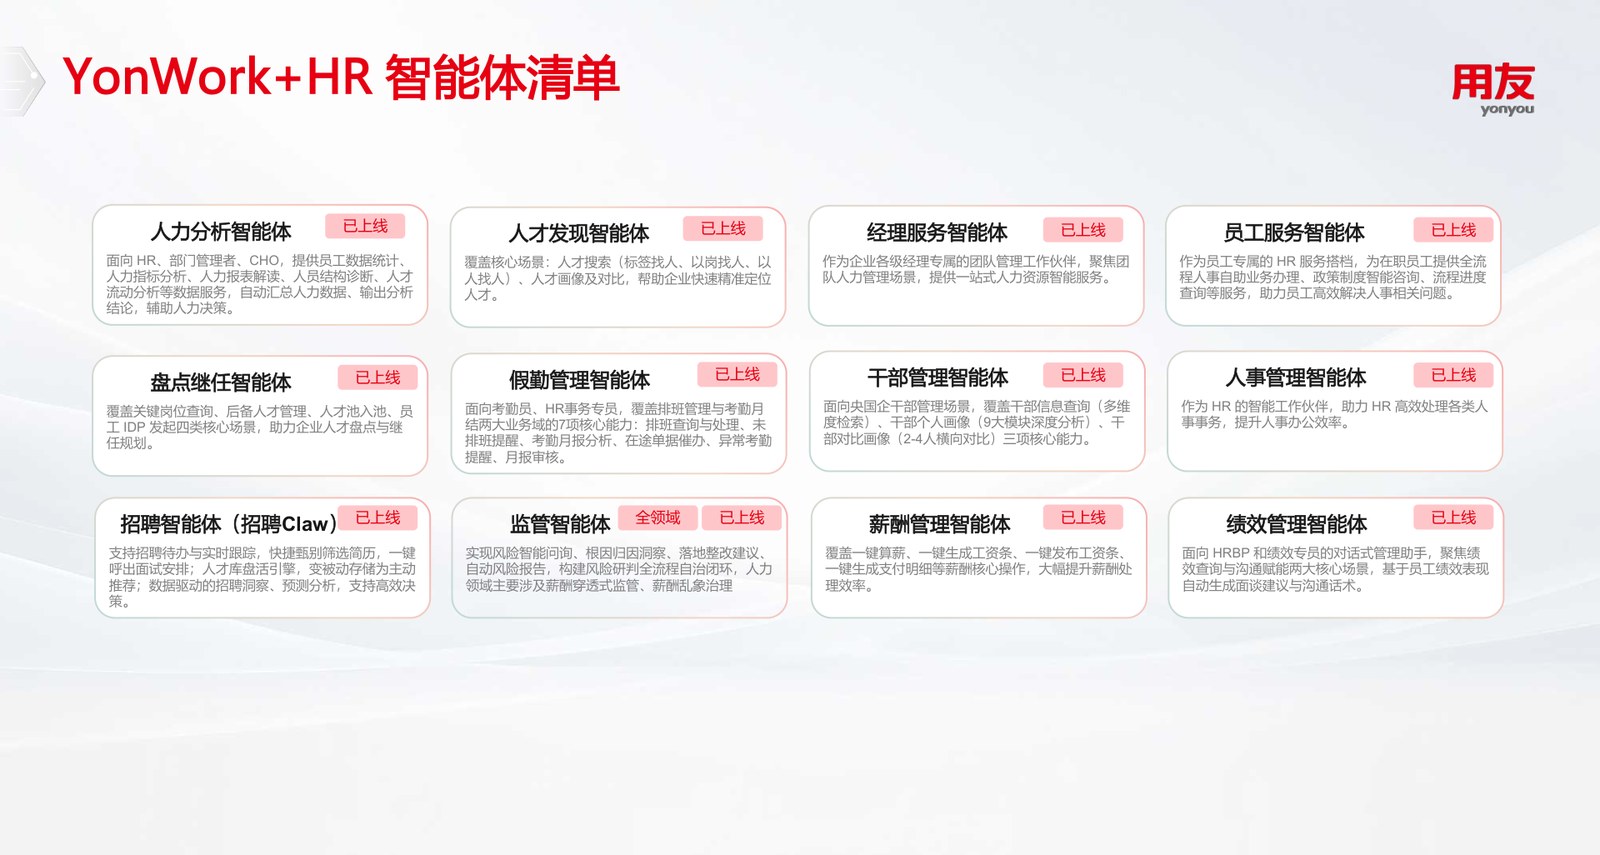
图2:平台式编排的能力覆盖
落地节奏按等级逐级推进。L1 任务可托管:动作定义成带依赖的任务,有状态回执,人不用守按钮。L2 判断可执行:核对经验写成断言,异常清单自动派单。L3 决策可解释:补齐参数快照与审批链,结果能自证,这一级才具备无人值守条件。
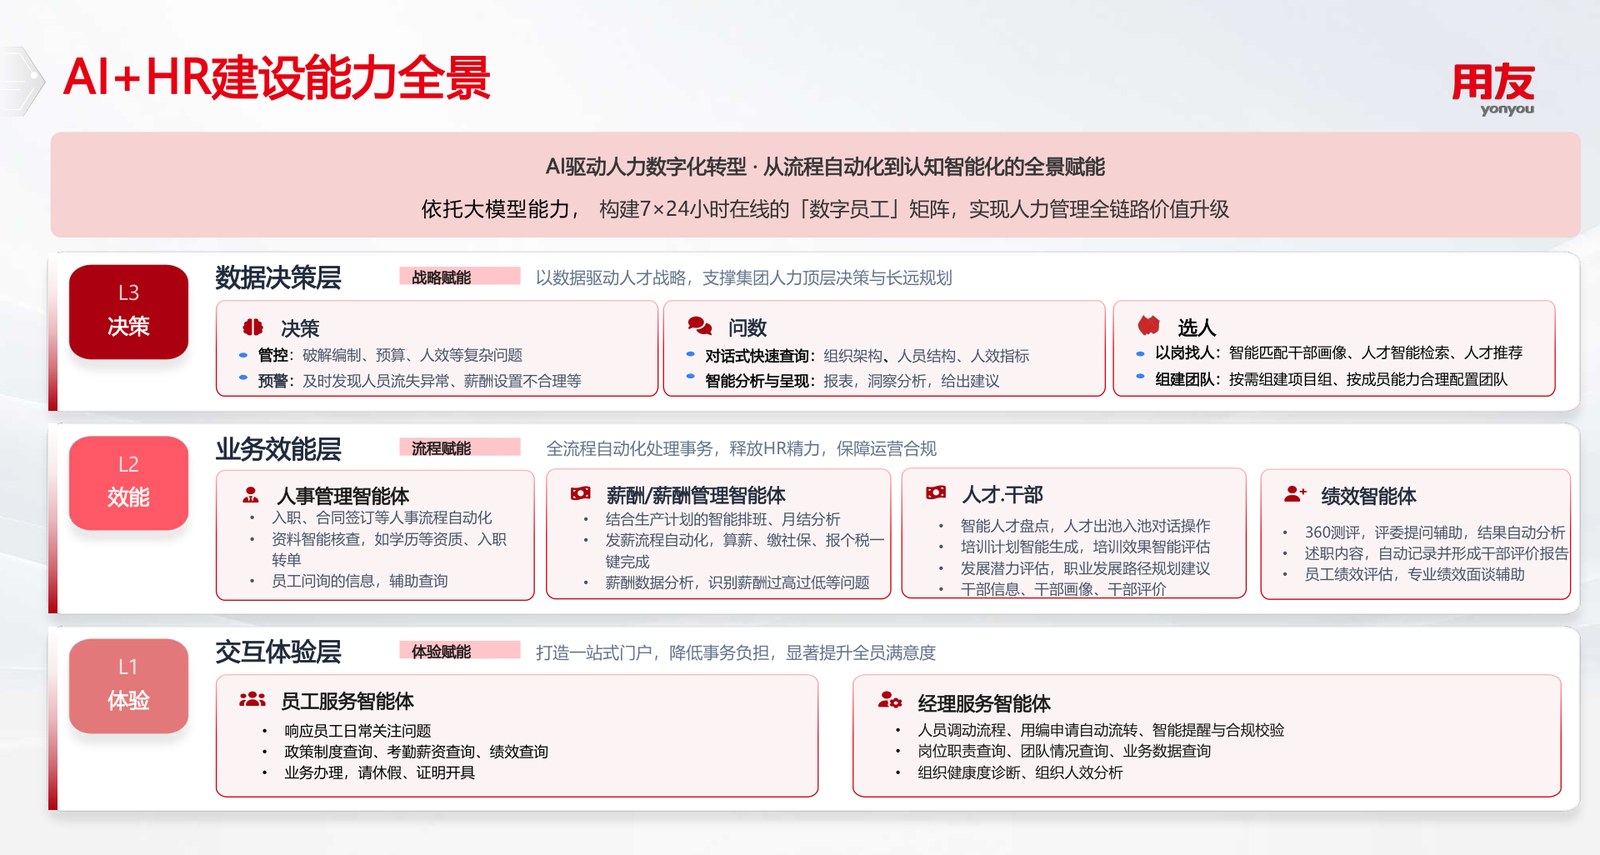
图3:三层能力演进与L1-L3自动化等级的对应
该平台是基于AI技术的新一代数智化人才管理平台,围绕精准人才发展、敏捷组织变革、智能人力运营、卓越员工体验四条价值线构建能力,把上述运行态能力做成产品内置项。
三个执行域已自动化。 薪酬智能助理以智能算薪中枢为核心:社保侧支持增减员提醒、缴交数据生成与一键审核,可按组织范围与缴交月份预配置定时任务;算薪侧按设定时间与发薪模式自动计算、生成发放单,输出算薪报告并支持银行报盘与工资条;个税侧按预设规则触发增减报送、同步专项附加扣除、执行申报缴款。
运行态四件事都有落点。 定时任务与执行轨迹对应可观测性,参数快照与规则版本对应可追溯,校验规则对应可判断,异常分类与审批链对应可收场。算薪报告与异常归因由模型推理完成,纸质材料通过多模态识别与实体抽取入库;员工侧政策咨询走自然语言处理与语义理解,先做意图识别,再用向量嵌入与向量数据库做检索增强生成,答案模板由提示词工程固化。
图4:薪酬管理智能体的能力边界
平台规模。 该平台基于自研大模型 YonGPT,支持接入 DeepSeek、通义千问等外部模型并可基于企业口径微调,训练数据不出域;云原生部署架构提供 4000+ OpenAPI。据用友官方公开资料(2024-2026),服务逾9000家企业、7000万余用户;连续4年入选 Gartner 千人以上规模企业 HCM 云魔力象限。
对要把薪酬作业从"人盯"推到"系统自证"的集团,用友 BIP 人力云的价值不在功能清单长短,而在调度、校验、异常、审计是否同一套引擎。
Q1:多法人集团一起上还是分批上?
按法人分批,每批跑满一个完整发薪周期再扩。判据3条:连续2个周期无人工干预完成算薪、异常当日内闭环、报盘与核对一致。
Q2:大模型在算薪里能替人做到哪一步?
适合归因与解释:异常清单按原因聚类、生成算薪报告、解释金额变动构成。不适合业务判定:离职员工该不该发、基数超限要不要报批,留给人。
Q3:社保基数跨地市不一致,参数快照要存到什么粒度?
至少存到参保地+险种+年度上下限+启用日期。同一集团不同法人常分属不同统筹区,只按年度存一个基数,事后无法解释各地扣款差异。
Q4:审计留痕会不会拖慢算薪速度?
留痕是写操作,开销在毫秒级,与算薪计算不在一个量级。真正的成本在前期的数据模型设计——把执行轨迹、参数快照、规则版本设计进表结构。
Q5:已经上了薪酬系统,还需要单独搭编排平台吗?
先看现有系统有没有任务依赖与状态回执。若只能定时触发、失败靠翻日志,补一层编排比换系统便宜;若本身带调度与审计,做配置而非重构。
1. 无人值守的前提是可观测,不是自动化程度高。任务没有状态回执,自动化只是把错误提前。
2. 4个任务要素里最易被忽略的是幂等键。没有它,重跑一次就是双倍工资。
3. 回滚的边界止于报盘。资金流出后能做的是冲正与审批,不是撤销重算;取数产物应是带版本的结构化快照,快照决定事后能否自证。
销售热线
4006-600-577联系我们