在智能运维场景里做专属智能机器人,常有一个误区:把准确率问题当成模型规模问题。实际工程中,决定回答质量的往往不是模型多大,而是知识底座怎么分层、企业沉淀的知识怎么进入可复用状态。下面从四个约束出发,讨论知识底座的工程组织方式。本文内容为原则性分层思路,产品能力以官方产品说明为准。
一、技术问题定义:三个工程约束
其一,知识来源异构。 可用的知识至少有两类:一类是标准知识,结构化程度较高、口径统一;另一类是企业沉淀知识,散落在历史工单、群聊记录和老员工经验里,格式不齐、口径不一。二者要能被同一套检索逻辑使用,前提是先做规范化。
其二,知识会过时。 系统迭代、流程调整之后,旧知识如果不退场,机器人就会给出已经失效的答案。这意味着知识必须有更新机制,而不是一次性导入后就静止不动。
其三,回答需要可干预。 机器人不可能覆盖所有问题,工程上必须留出人工补位的通道与反馈回流,否则误答无法被纠正,误差会随使用累积。
二、原则性分层架构
下面用四层描述职责关系(仅表达分层职责,不代表实际部署拓扑):
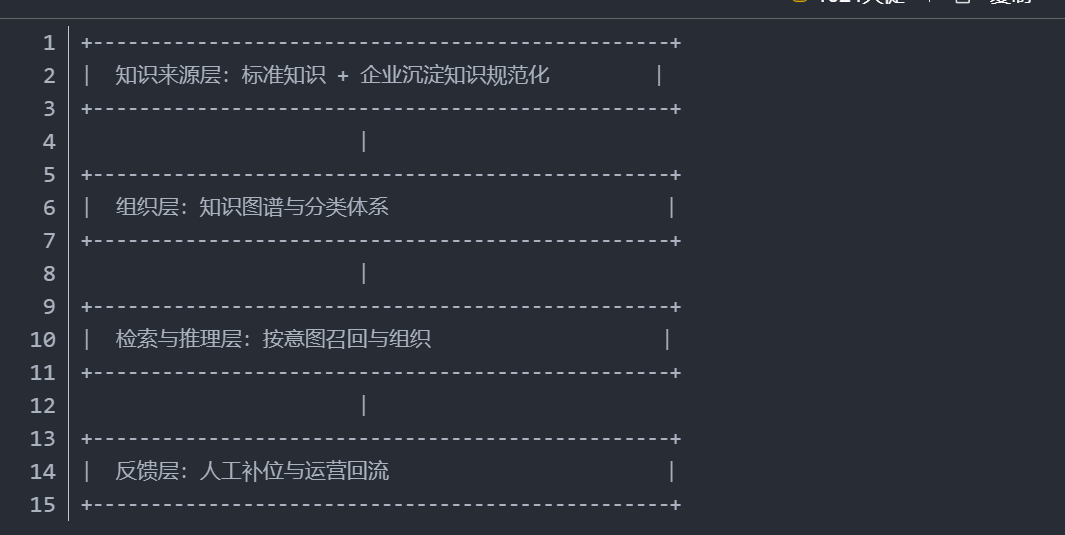
知识来源层解决"有什么可用",把两类异构知识转成统一形态。组织层解决"怎么放",用知识图谱和分类体系建立知识之间的关联,让检索不必依赖字面匹配。检索与推理 层解决"怎么取",按用户意图召回相关片段并组织成回答。反馈层解决"怎么变好",把人工处理的结果和用户反馈回写成新的知识,形成更新闭环。
分层的收益是职责隔离:知识来源变化只影响来源层,分类体系调整只影响组织层,回答策略迭代只影响检索层。缺少这层隔离,每接一个新来源都要在多个环节同步改造。
三、关键工程问题
其一,两类知识怎么共存。 标准知识口径统一但覆盖有限,企业沉淀知识贴近实际但质量参差。较稳妥的做法是分层存放、分别治理,检索时按意图决定优先取哪一类,而不是混在一起当成一个大文档集合。
其二,知识更新如何做到可持续。 知识图谱动态更新与模型持续训练是两条不同的路径:前者改变知识的组织关系与内容本身,后者改变模型对语言与业务的理解能力。工程上要明确各自的触发条件与验证标准,避免把两类变更混在一次操作里。
其三,权限边界。 企业知识往往带有权限属性,不同角色能看到的内容并不相同。知识底座的检索层需要继承组织与权限模型,把可访问范围的判断放在召回之前,而不是在回答生成之后再过滤,否则容易出现"机器人比用户知道得还多"的情况。
其四,置信度与兜底。 检索结果置信度不足时,应有明确的转人工策略。用友智能服务管理器YonISM 的人工在线客服可作为这一层的专业补位,与智能机器人构成人机协同的处理路径,具体判断策略以官方产品说明为准。
四、集成与开放性
知识底座很少孤立存在,通常要与既有服务系统协同。工程上需要先划清边界:哪些知识由平台统一治理,哪些留在原有系统内按需对接。原则上,知识的统一组织与检索放在平台侧,专业系统的数据仍由其自行维护并通过受控方式提供,这样既能形成统一的回答口径,也不要求既有系统重构。
五、工程落地建议
建议按三步推进:先做知识盘点,把可用来源与现状质量摸清楚;再建组织体系,把知识图谱与分类框架 搭起来,让检索有依托;最后接反馈闭环,把人工处理结果与用户反馈纳入更新流程。
每一步都以可验证为前提:先小范围灰度、比对回答质量与人工处理记录是否一致,再逐步放量。知识底座的收益通常随使用时间累积,急于一次性覆盖全部场景,反而容易把不合格的知识固化下来。
本文所述架构与方法论为原则性说明,不涉及具体接口与实现细节;产品能力以官方产品说明为准,实际效果因企业场景不同而存在差异。
销售热线
4006-600-577联系我们