在智能运维类 项目的实施过程中,流程需求的变化频率往往高于预期:组织调整带来审批环节
变化,制度修订带来时限变化,业务扩张带来新的流程分支。如果每次变化都走一次开发排期,
平台的适应能力会迅速成为瓶颈。这篇文章讨论的工程解法,是把流程从代码里解耦,交给可
配置的引擎承载。
以下只涉及原则性架构与方法论,具体能力以官方产品说明为准。
一、技术问题定义
所谓"流程写死",指流程的节点、分支、时限与责任人都固化在业务代码中,变更必须改代码
并重新发布。代价不只是发布成本高,还有隐蔽后果。
一是变更窗口长:从提出调整到真正生效隔着一个研发周期。二是版本不可追溯:流程改过几
次后,很难说清工单按哪一版规则流转。三是知识与代码绑定:规则散落在代码里,业务人员
无法独立维护。
需要区分的是:流程引擎要解决的不是"让流程自动化",而是让流程定义与执行分离——定义
由业务侧维护,执行由引擎驱动。
二、原则性分层架构
可配置的流程架构通常按职责分成四层。下图只说明分层关系,不代表真实部署拓扑。
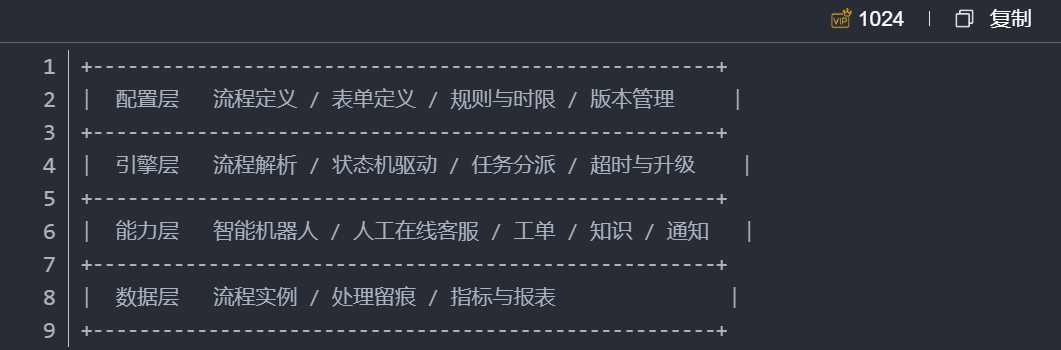
配置层负责"流程长什么样",由业务侧维护,产出可版本化的定义。引擎层负责"流程怎么
跑",把定义解析为可执行的状态流转,并处理分派、超时与升级。能力层是各节点调用的
服务,比如某节点触发智能机器人推荐、另一节点转入人工在线客服。数据层以流程实例记
录全过程,为报表提供数据。
分层的意义在于变更范围可控:调整审批节点只需改配置层,不影响引擎与能力层;更换某
节点的处理方式只需替换能力层的实现。
三、关键工程问题
有四类问题需在设计阶段想清楚。
流程定义的可版本化。 定义一旦可配置就会持续演进,需明确在途实例按发起时的版本执行、
还是统一升级。前者保证单笔一致性,后者保证规则统一。无论选哪种,版本与实例的关联
都必须可追溯。
组织与权限模型的绑定方式。 节点上的"谁来处理"通常不是某个人,而是角色或组织单元。
这要求引擎与权限模型解耦:节点引用角色标识而非具体账号,人员变动由组织侧维护;若
直接绑账号,流程配置就成了人员台账的副本。
超时与升级规则。 超时判定需引擎侧统一计时,而非各节点自行判断;升级规则同样作为配
置项 ,便于按流程类型差异化设置。
知识回流的位置。 知识库 不是流程之外的独立模块。把处理结论沉淀为知识条目、作为流程
闭环的后置动作,才能让经验被复用。用友智能服务管理器YonISM 把知识流程与事件、问题流程放在同一平台。
四、集成与开放性
流程引擎很少独立存在,需要与既有系统协同:一方面与用友 NC、NC Cloud、YonBIP 等服
务系统对接,另一方面接入第三方系统,实现统一运维集中管理。具体集成能力以官方说明
为准。
集成需关注两点。其一是边界清晰:流程引擎负责流转与状态,业务数据仍由各自系统持有,
避免把它做成数据集中层。其二是变更可隔离:外部系统的接口调整不应导致流程定义重写,
通过能力层做适配即可。
智能运维场景下,流程引擎还可能调用智能体 类能力,例如在某节点触发专属智能机器人的
知识问答。这类调用同样建议收敛在能力层,让流程定义只描述"调用什么能力"。用友智能
服务管理器YonISM 通过可视化流程引擎配置流转规则,从工单发起、审批流转到执行反馈
实现全链路在线化。
五、工程落地建议
落地建议分三步,每步都有验收点。
起步阶段先做"定义与执行分离":把最常变更的一到两条流程搬到配置层,验证业务侧能否
独立完成调整。验收点是不需要研发介入即可生效。
接着补齐版本与权限:明确在途实例的版本策略,节点责任人改为引用角色标识。验收点是
组织调整后流程无需重配即可运行。
再进一步做能力层接入:把知识回流、智能推荐等作为流程节点的标准动作。验收点是新流
程可复用已有能力。
需要提醒的是,可配置化本身不是目的。配置项过多而缺少治理同样会带来维护负担:只把
真正会变的环节做成配置。具体实现细节与接口能力以官方产品说明为准。
销售热线
4006-600-577联系我们