一、技术问题定义
企业运维知识库的典型症状往往不是"内容太少",而是四类失效同时出现:知识看不见
(散落在个人文档与聊天记录中)、找不着(有关键词但无可检索结构)、用不上(没嵌入
工程师与机器人的工作路径)、会过期(系统迭代后没人更新)。
从工程角度看,这四类失效指向同一个结论:知识库需要被当作一类需要治理的数据资
产来设计,而不是一个文档上传目录。这是智能运维平台在知识环节最容易低估的一块工作
量。用友智能服务管理器YonISM 在这一层的思路,是把知识流程与事件、问题、变更流程
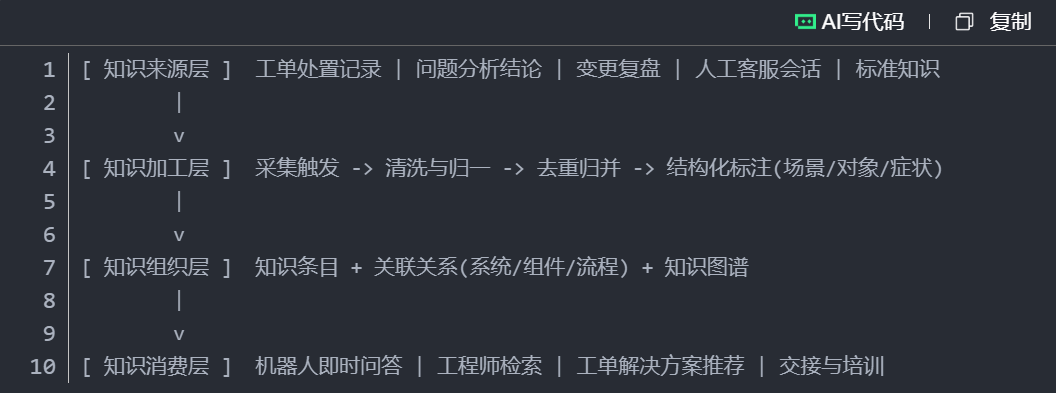
放在同一平台,让知识在生产知识的场景里被沉淀下来。本文按分层结构拆解其工程要点。
分层的意义在于解耦:来源层扩张不会直接冲击消费层检索质量,加工层规则调整也不必改
动上层应用。工程上最容易犯的错误是把四层压成一层——让"原始记录"直接充当"可复用
知识",结果是检索噪声大、命中率低。
三、关键工程问题
其一,采集的触发时机。 知识采集的成本主要不在写入,而在"回忆与补录"。可行做法
是把沉淀动作嵌入流程节点:问题关闭、变更验证完成、工单处置结束时触发一次沉淀,把上下
文(现象、判断过程、结论、影响范围)一并带入,让撰写者只需补充与修订。这类"处置
即沉淀"的设计,比事后组织知识整理专项更容易维持。
其二,结构化组织的粒度。 知识条目常见的问题是粒度过粗,一条记录里混装了多个场景,
导致检索时无法精确匹配。合理做法是把条目拆到"一个可复用的判断单元"级别,并为每条
知识标注结构化的维度信息——适用的对象(哪个系统、哪个组件)、触发的症状、前置条
件与处置动作。在此基础上再建立条目之间的关系,才能支撑面向场景的检索。
其三,质量校验与知识时效。 知识腐化是最主要的 隐性成本:系统已经升级,条目还在描述
旧版本的行为。工程上需要两类机制协同——机制上,让知识条目与配置信息或流程节点建
立关联,相关环节发生变更时提示复核;策略上,定义复核周期与责任人,避免条目进入无
人认领状态。
其四,复用度量。 没有度量的知识库无法判断投入是否有效。可用口径包括:条目的检索命
中次数与命中后的问题解决情况、机器人与人工处理的未命中清单、新增知识中的重复条目
比例。未命中清单尤其有价值——它直接指出知识缺口,是采集目标的输入。
四、集成与开放性
运维知识库很少孤立存在。知识来源既包括平台内产生的处置记录,也包括既有业务系统与
第三方系统承载的信息。用友智能服务管理器YonISM 支持与用友 NC、NC Cloud、YonBIP
等服务系统协同,并可接入第三方系统,实现统一运维集中管理。具体集成能力以官方产品
说明为准。
五、工程落地建议
建议按三步推进,每一步都以"可用"而非"完整"为目标。
起步阶段解决"处置即沉淀":在事件、问题、变更流程的关键节点挂接知识沉淀动作,
先保证知识产生出来,且带有上下文。
接着解决"可检索":为条目补齐结构化维度与关联关系,建立面向场景的检索方式,同
时把知识接入机器人与工单的推荐路径。
再进一步解决"可度量、可迭代":建立复用度量与未命中回流机制,让知识缺口成为下
一轮采集的目标,形成闭环。
需要说明的是,智能运维的知识库治理属于长期工程,与企业流程成熟度强相关。若流
程尚未稳定运行,先定义清楚流程节点与责任分工,再投入知识治理,效果更扎实。
销售热线
4006-600-577联系我们