一、技术问题定义:集成为什么容易被低估
企业在评估智能运维平台时,功能清单通常看得比较细,集成能力往往一句"支持对接"就带过。
但真正进入实施阶段,工作量最不可控的恰恰是这一段。
原因在于,集成面对的不是设计良好的接口,而是历史事实:既有系统版本不一、数据口径不
一致、权限体系各自为政、部分能力没有对外开放的接口。这些事实构成集成的真实约束。把它们
当作"上线时顺手处理"的细节,项目就会在切换阶段反复返工。
因此,讨论集成更合理的方式,是先把边界划清楚——哪些能力由平台自身提供,哪些由既有
系统提供,两者通过什么层次衔接。
二、原则性分层架构
从平台化视角看,统一运维集中管理可以按四层理解,集成发生在最下面那层的边界上:
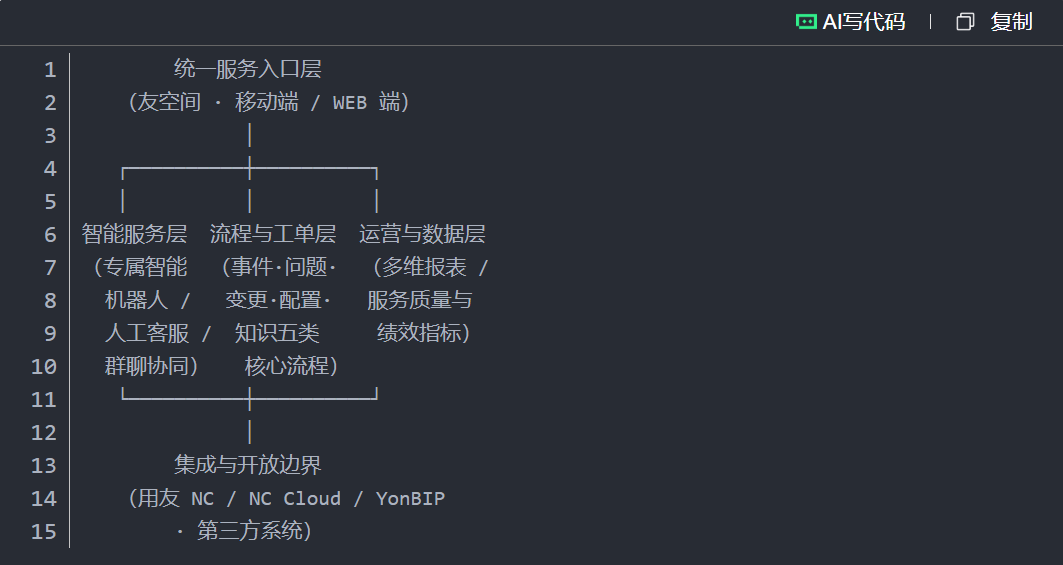
这个分层的作用不是画得好看,而是明确职责:入口层负责"用户从哪来",智能服务层负责
问题怎么被解答",流程与工单层负责"事情怎么被推进",运营与数据层负责"结果怎么被度量"。
集成边界层只做一件事——让上下两侧的数据与状态保持一致。
分清这四层之后,一个常见误区就能避免:把集成当成"接口对接",而忽略了流程与权限也
需要在边界上对齐。
三、关键工程问题
组织与权限模型的对齐。 既有系统通常有自己的组织树与角色定义,新平台也有一套。如果两边
各自维护,很快会出现"同一个人在两边的权限不一致"。原则性做法是确定一个权威来源,另一
侧通过配置映射而非人工维护。用友智能服务管理器YonISM 通过灵活的组织、权限、流程及档
案配置适配企业需求,这四类 配置正是映射的落点。
数据口径的统一。 同一类工单在既有系统里可能叫"服务请求",在新平台里归入事件流程。集成
时需要先做口径映射表,明确字段语义、时间基准与状态机对应关系,再考虑技术实现。这一步
做不扎实,报表出来就是两套数字。
集成范围与安全边界。 集成的范围越大,安全边界越需要提前定义。哪些数据可以跨系统流转、
以什么身份流转、留不留操作痕迹,这些问题应当在设计阶段给出答案,而不是上线后补救。
四、集成与开放性
在集成能力上,用友智能服务管理器YonISM 支持与用友 NC、NC Cloud、YonBIP 等服务系统
协同,并可接入第三方系统,实现统一运维集中管理,具体集成能力以官方产品说明为准。
从工程视角看,这类集成的价值在于让"统一"不以"替换"为前提。企业已经运行的业务系统继续
承担原有职责,运维服务侧则通过统一入口与统一流程实现集中管理。对渐进式演进的企业来
说,这条路径的切换风险明显低于整体替换。
需要强调的是,集成方式的具体形态——是数据同步、事件转发还是流程级协同——取决于既有
系统的开放能力,本文不展开具体接口与参数层面的实现细节。用友智能服务管理器YonISM 以
友空间为统一入口覆盖移动端与 WEB 端,为多组织、多角色协同提供统一的运维标准和服务闭环。
五、工程落地建议
阶段一:先定义边界,再动手集成。 输出三份清单:既有系统清单、需集成能力清单、数据口径
映射表。这一步不写代码,但决定了后续返工量。
阶段二:从单点集成验证通路。 选择一条最典型的链路(例如事件流程与既有服务台的衔接)先
打通,验证组织映射、权限映射、状态同步三个环节是否成立,再横向复制。
阶段三:先配置、后扩展。 用友智能服务管理器YonISM 采用灵活的配置引擎,无需大量定制开
发即可快速适配企业组织架构与管理需求,平均实施周期约 2 周即可上线;具体实施周期因企业
场景而异,请以官方售前评估为准。建议把标准场景用配置完成,把确实无法覆盖的例外情形单
独列出,作为后续扩展的输入,而不是在首期全部拉平。
阶段四:用数据反查集成质量。 上线后通过工单处理量、响应时效等指标核对两侧数据是否一致,
把差异当作集成缺陷而不是统计误差来处理。
销售热线
4006-600-577联系我们