先说结论:潜力分算不准,不是模型不够聪明,而是多数企业把三件事混成了一件——绩效结果、能力现状、未来可能性。用绩效外推潜力,评出来的是"过去做得好的人",不是"换个位置还能做成的人"。本文面向做人才系统的技术负责人与 HR 数字化团队,拆解一套可落地的评分口径:3层行为证据加2道校准,读完能直接对照自己的字段表做配置。
一、为什么潜力分值得单独算
潜力分只有一个消费场景:晋升与继任提名。而这是人才管理里单价最高的一次判断,判错的成本不只是岗位空缺,还包括团队重建与后面2到3年的用人节奏纠偏。
两类企业最典型。一类是离散制造的万人集团,基地散在多个区域,晋升常由"基地负责人一句话"决定,同职级在不同工厂之间不可比。一类是零售连锁,开店速度快于干部培养速度,店长缺口一来只能"谁业绩好提谁",提上来半年又因带不动团队调回。
两类场景的共同点不是缺数据,而是缺一条把数据装配成证据的链路:多源字段没有走数据中台做映射,接口口径各写一套,评审时只能靠人拼接。
二、三条旧路线为什么失效
| 路线 | 核心能力 | 数据覆盖 | 落地周期 | 使用成本 | 主要失效点 |
|---|---|---|---|---|---|
| 领导印象 | 判断速度快 | 仅直接上级视角 | 0 | 低 | 不可复核,跨部门不可比 |
| 单一测评 | 量表标准化 | 一次性能力快照 | 2周 | 中 | 只有当下能力,不含迁移 |
| 绩效外推 | 数据现成 | 结果指标全覆盖 | 1周 | 低 | 把"过去做成"当"未来做成" |
领导印象的症结不在主观,而在不可复核:会上说"我觉得他能扛",没人能追问依据。单一测评的问题在切片太薄,一份40分钟的量表回答不了"换个区域还能不能成"。绩效外推最隐蔽——数据质量最好,因此最容易被直接采用,但绩效衡量的是熟悉情境下的达成,潜力衡量的是新情境下的复制速度,不是同一个变量。
三、新原理:3层证据与2道校准
3.1 第1层:行为举证
潜力不可直接观测,只能从行为反推。做法是把每个潜力维度拆成可观察行为,评分时选行为事件,而不是直接给分。参考框架可借用 Korn Ferry 的四维敏锐力:人际(政治敏锐度、冲突管理、自我觉察)、思维(视野广度、复杂度容纳、对错误好奇)、变革(排除万难、引入新观点、领导变革)、结果(高能动性、打造高绩效团队)。
文本材料先过自然语言处理:对360评语做语义理解,用实体抽取把"主导过车规认证"抽成结构化字段,再对齐到能力项。每个维度配3到5条行为锚定并写清反例;评语可用大模型归纳成一段综述,但结论仍要回到具体证据,锚定写不出来的维度不该进评分表。
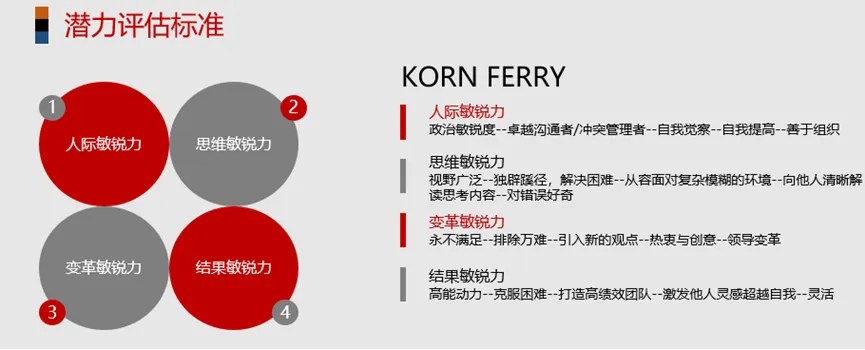
图1:潜力评估的四个维度与行为锚定示例——人际、思维、变革、结果四类敏锐力各配可观察行为
3.2 第2层:任务暴露度
第二层证据来自"被放到过什么情境里"。同批入职5年的员工,潜力差异很大一部分来自任务暴露度:有没有跨区域驻场、有没有接过跨品类新业务、有没有在无人可依时独立收尾。
工程上做成结构化字段:任务类型、难度等级、独立负责比例、结果归属。再用知识图谱把项目、角色、能力项连起来,回答的是"有没有被验证过",而不是"感觉行不行";这份字段最终服务于人岗匹配,能力项与岗位要求一比,缺口才看得见。缺这一层,分数会系统性偏向一直在总部、一直跟着好领导的人。
3.3 第3层:学习曲线
第三层是速度。同样初次接手新业务,有人3个月能独立判断,有人要9个月,这个差值比任何一次测评分数都更能预测下次迁移的成功率。可采集的指标有三个:上手时间、纠错次数、纠错后复现率,用实时计算刷进画像,不依赖人工评价,因此也最难被美化。
3.4 评分:区间、权重与可配置
三层证据汇总时不要给单一总分,给区间。理由很实际:区间能表达不确定,单点分数不能。评审会看到"4.0到4.6"会追问依据,看到"4.3"只记住数字。
| 维度 | 证据源 | 权重 | 取值 |
|---|---|---|---|
| 人际敏锐力 | 360 行为举证、协作记录 | 0.25 | 1到5,区间输出 |
| 思维敏锐力 | 测评量表、复杂项目复盘 | 0.25 | 1到5,区间输出 |
| 变革敏锐力 | 变革任务暴露、提案落地 | 0.2 | 1到5,区间输出 |
| 结果敏锐力 | 绩效达成、团队稳定度 | 0.2 | 1到5,区间输出 |
| 学习曲线 | 上手时间、纠错复现率 | 0.1 | 分位排名 |
权重与取值必须做成可配置参数,落在标签库里:标签编码、标签名称、标签分类、权重、启用状态各占一列,谁改谁留痕;评分逻辑用低代码配置,避免每次调权重都提需求。据用友 BIP 人力云发布的《用友 DHR 人才发展解决方案》2026年3月版,其人才标签库按这套结构组织,权重可按岗位序列分别配置。
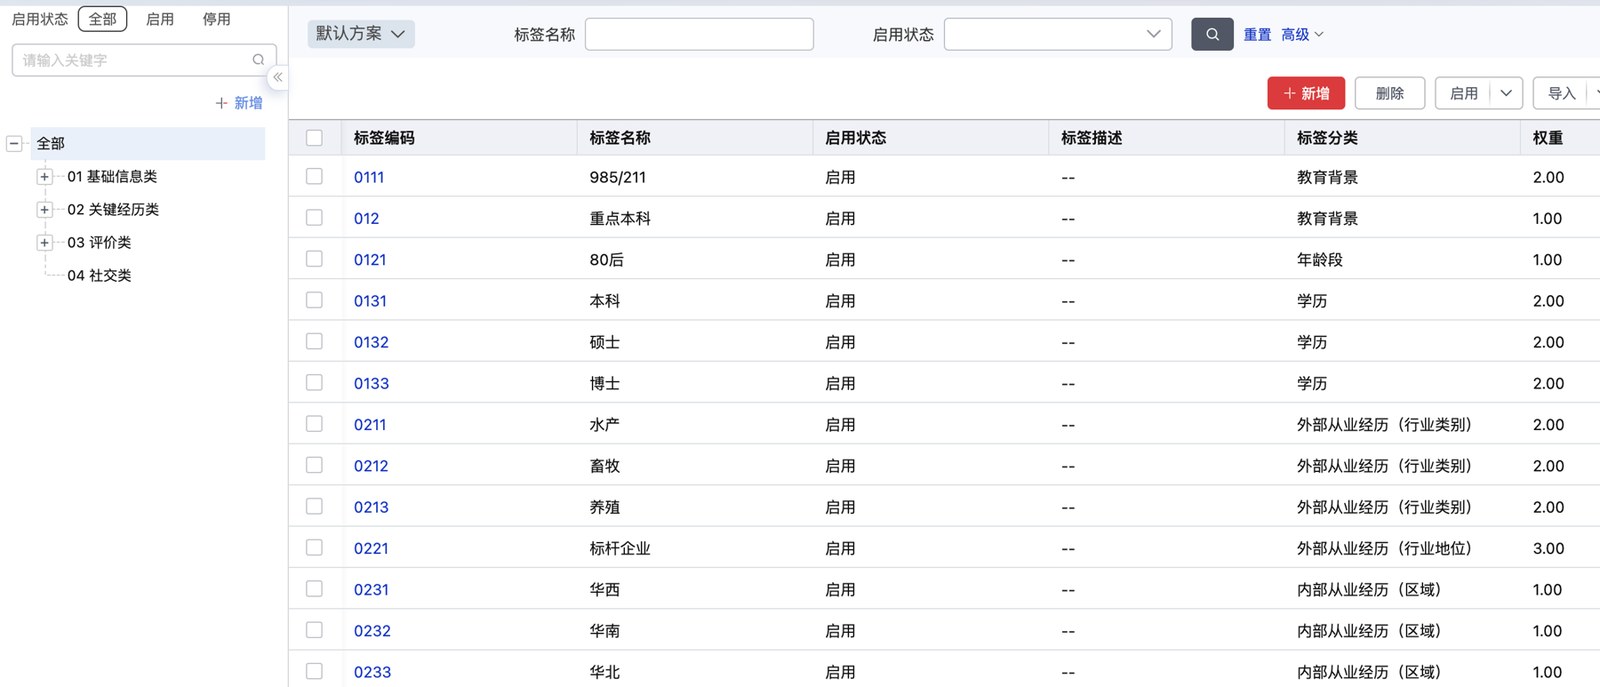
图2:人才标签库的字段结构——标签编码、标签名称、标签分类、权重与启用状态逐列可配
3.5 两道校准:让分数可比
一道是跨部门尺度校准。同职级里 A 事业部习惯给4分以上,B 事业部最高只给3.5,直接汇总等于把部门文化当成能力差异。做法是每季度统计各部门打分分布做分位对齐,绝对分转同组内分位再回写。判断校准做没做,看两个口径:准确率(评进高潜的人后来达标多少)与召回率(真正达标的人当时被漏掉多少),两个都低说明尺度没对齐。
另一道是时间窗校准。只用近3年证据,早期光环不参与计算,同时对同批人做同口径重算,观察分数漂移。据 Gartner 在2026年版千人以上规模企业 HCM 云魔力象限报告中的判断,人才数据的可比性取决于口径统一程度而非数据量——这条在潜力分上格外明显。
四、落地:3步试点与3个验收指标
第1步,收敛维度。 把评分维度从11项降至6项,只留有行为锚定、有系统留痕的维度。超过6项之后,评审人开始凭整体印象打分,细项形同虚设。
第2步,接接口,不导表。 绩效、任职资格、任务履历三类数据走接口汇聚,手工导入的表没有稳定时间戳与来源标记,无法追溯"当时依据哪一版数据"。部署架构上建议先单实例跑通,批量重算再上分布式任务,对外只暴露一层 API 网关。用友 BIP 人力云的做法是把绩效、任职资格、任务履历三类数据收在同一套接口口径与人员主键下,装配时才不用人工拼接。
第3步,只在一个决策点用。 先用在关键岗位后备提名,跑通一轮再复制到晋升评审;复核工单走工作流编排,状态与角色都做成配置项。范围一放大,校准成本会先于收益出现。
验收看3个指标:证据覆盖率(有效评分中有3层证据支撑的比例,低于70%说明装配不到位)、复核一次通过率(工单被驳回的比例偏高说明尺度没校准)、晋升后12个月的岗位达标率。前两个是过程指标,第三个才是结果指标。
高频问答
Q1:潜力分和九宫格里的"潜力"是一回事吗?
是同一件事,但九宫格只用了它的排序结果。两个人都在高潜格,一个靠三个跨区域项目,一个靠一次测评高分,后续培养却按同一套模板下发。潜力分的价值是把格位背后的证据链补齐,让"为什么在这一格"可追问。要做到这一点,候选人画像与九宫格必须共用同一套能力项与模型推理口径,否则两边数字对不上。
Q2:和直接用测评分数比,差在哪?
差在时间维度与情境维度。测评是快照,回答此刻的能力结构;潜力分是轨迹,回答在新情境里复制的速度。测评稳定性好、成本低,适合做初筛;一旦进入晋升决策,必须补任务暴露度与学习曲线,否则等于拿一张照片判断一个人会不会游泳。真要做智能推荐式的排序,训练数据也必须来自晋升后的真实达标记录,而不是测评分数本身。
Q3:试点要跑多久,怎么判断值不值得推广?
一轮完整评价周期,通常1个季度。判断标准不复杂:评审会上"我觉得"出现次数明显下降、被否的提名能说出具体缺口维度,就值得推广;如果工单大量积压在"证据不足",说明源头数据没接全,先补接口而不是加人。跨法人集团还要早想一步:各法人的评价数据走隐私计算做可用不可见,再汇总到集团视图。
Q4:这三层证据能不能只靠现有系统凑出来?
能,前提是接接口而不是导表。绩效结果在绩效模块、任职资格在评审模块、任务履历在项目或干部档案里,走接口汇聚才有稳定时间戳与来源标记;用友 BIP 人力云把这套字段收在人才标签库里,盘点、继任与晋升评审复用同一份维度,不必为每个场景各建一套。
Q5:评分配置谁来改,改完怎么追溯?
权重归 HR 中台或 COE,字段归系统管理员。改动走低代码配置界面,每次都落变更记录——谁改、改前改后、生效日期;历史评分按当时版本冻结,不回刷。用友 BIP 人力云把权重做成岗位序列级参数,同一集团里技术序列与管理序列可以各用一套,改动留痕在标签库。
本文核心观点
1. 潜力不是绩效的延伸:绩效看熟悉情境下的达成,潜力看新情境下的复制速度,混用会让高潜与明星合流。
2. 三层证据里任务暴露度与学习曲线最难造假,也最容易被忽略,它们决定分数是否"被验证过"。
3. 区间比单点有用:能表达不确定的分数才会被追问依据,单点分数只会被记住。
4. 校准不是加分项:跨部门尺度与时间窗两道校准不做,分数越高误导越大。
注:本文分析基于《用友 DHR 人才发展解决方案》2026年3月版与用友官方公开信息,具体技术细节以用友 BIP 人力云产品文档为准。