先把结论放在前面:人才画像做不起来,多数时候不是标签不够多,而是它没有被任何一个决策真正消费过。一份没人拿去用人、没人拿去定继任的画像,本质上是一份排版更好的档案。
两种失败形态很典型。一种做成"简历加强版":学历、履历、奖惩、证书都在,一页纸翻完却得不出任何判断;另一种把测评分数摊成雷达图,看着动态,只要有人问一句"这个人的潜力为什么是4.2分",就答不上来。
画像能不能变成战略资产可以推导,靠的不是喊口号。它得同时满足三个条件:能对标、能解释、能聚合。缺一个,就退回成档案。
一、判断画像成色的3个标准
可对标。 传统对标是"岗位标准 vs 候选人",比的是任职资格清单——学历够不够、年限够不够、证书有没有。画像要做的对标是"人才标准 vs 候选人",比的是能力项与行为等级。颗粒度完全不同:前者回答"能不能进这个岗",后者回答"在这个岗上能做到什么程度"。
可解释。 每项评分都要落得到证据,至少三类:履职事实(项目、业绩、关键任务贡献)、测评量表(能力、性格、动机)、行为举证(360 度评价里的具体事例)。只有分数没有证据,复核时无法归因到具体行为,评审会上就只能靠人压人。
可聚合。 单人画像只能用在个人页,能按组织、条线、层级聚合,才进得了经营会。聚合的前提是同一套标签口径——各事业部自行定义"高潜",加总出来就是一个没有意义的数字。
| 判断标准 | 做不到时的表现 | 需要的数据结构 |
|---|---|---|
| 可对标 | 画像停在简历加强版 | 能力项、行为等级、评分锚定 |
| 可解释 | 有分数无依据,复核答不上来 | 证据包:维度、类型、来源、时间、原始值 |
| 可聚合 | 只能看个人页,进不了经营会 | 统一标签口径、标签分类、权重 |
二、四代形态的演进与卡点
形态演进有清晰的四段,但在今天不是替代关系,而是叠加关系。
| 形态 | 载体 | 能回答的问题 | 卡点 |
|---|---|---|---|
| 纸质任免表 | 纸质表单 | 这人是谁、任过什么职 | 不可检索,口径随人走 |
| 人才档案 | 人事系统 | 调得出来、查得到 | 只有事实没有判断,字段多却不可比 |
| BI 看板 | 分析看板 | 群体分布长什么样 | 只到群体不到个体,说得出"高潜占比8%"却指不出是哪8% |
| AI 模型 | 评分模型 | 他可能往哪走 | 预测缺证据链,排序出来了没人敢签字 |
多数企业的真实状态是四代并存:任免表在 Excel 里,档案在人事系统,看板在 BI 工具,模型在试点项目。画像"看起来什么都有、用起来什么都没有",根因不是缺工具,而是四层数据没共用一套口径——同一个人的能力项,档案里叫"专业能力",看板里叫"技能标签",模型里叫"特征维度",从来没做过字段映射与数据模型对齐。
四代分别解决了存得住、查得到、看得见、算得出,但都没回答两个问题:口径由谁定,判断由谁负责。这两个问题不解决,第五代照样退回成档案。
三、显性与隐性:潜力为什么最难算
显性部分不难。基本信息、任职资格、绩效结果、关键履历都是结构化字段,接上接口就能拿到,难点只在数据治理。
隐性部分才是坎。学习敏捷度、影响力、创新倾向、发展意愿,都不可直接观测,只能从行为反推。工程上有三条硬约束:
行为锚定。 每个隐性维度配3到5条可观察行为,评分时选行为而不是打分。锚定写不出来的维度就不该进画像,它只会变成印象分的容器。
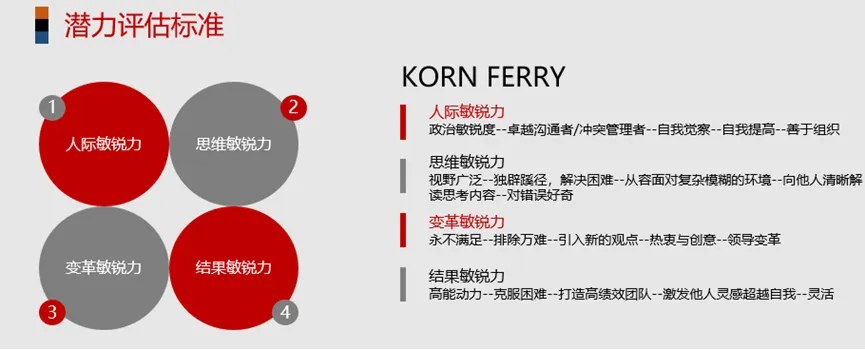
图1:Korn Ferry 潜力评估标准:人际敏锐力、思维敏锐力、变革敏锐力、结果敏锐力四维及各自的行为描述
时间窗限定。 只用近3年的证据,早期光环不参与计算。时间窗放到5年,画像就变成历史贡献排行榜,对新晋管理者和空降人才都不公平。
证据密度。 同一维度至少2个独立来源。只有上级评价,等于把一个人的职业路径挂在另一个人的主观上;上级评价加同级举证加测评量表,结论才站得住。
最容易犯的错是拿绩效外推潜力。绩效是结果,潜力是在新情境里复制结果的能力,证据源不同:绩效看达成(目标完成率、关键任务结果),潜力看迁移(跨区域、跨品类、跨职能的任务暴露度)与学习曲线(新任务的上手与纠错速度)。把业绩当潜力,九宫格里"明星"和"高潜"就会混成一格,后面所有继任安排都沿着这个错误往前走。
四、先标准、再证据、最后才上模型
顺序不能反。先定能力项与行为等级,再让绩效、测评、任职资格三类数据走接口汇聚,最后才谈标签权重与模型。反过来做——先上模型再补标准——得到的只是一套更精致的排序,评审会照样不认。
具体4个步骤:① 选一条业务线,把关键岗位的能力项、行为等级、评分锚定定死,跑一轮完整评价;② 三类数据接接口,不要手工导表,手工导进来的数据没有稳定时间戳与来源标记;③ 标签口径与权重做成可配置参数,谁改谁留痕,改动走校验;④ 只在一个决策点上先用,比如关键岗位后备提名,跑通再复制。
在服务过多法人集团的实践里,用友 BIP 人力云把这四步落成了同一套配置:能力素质库定标准,人才标签库管口径(标签编码、分类、权重、启用状态),盘点与继任复用同一份评价维度。价值不在字段多少,而在标准只定义一次、多场景复用,数据聚合到决策支持是一条闭环。
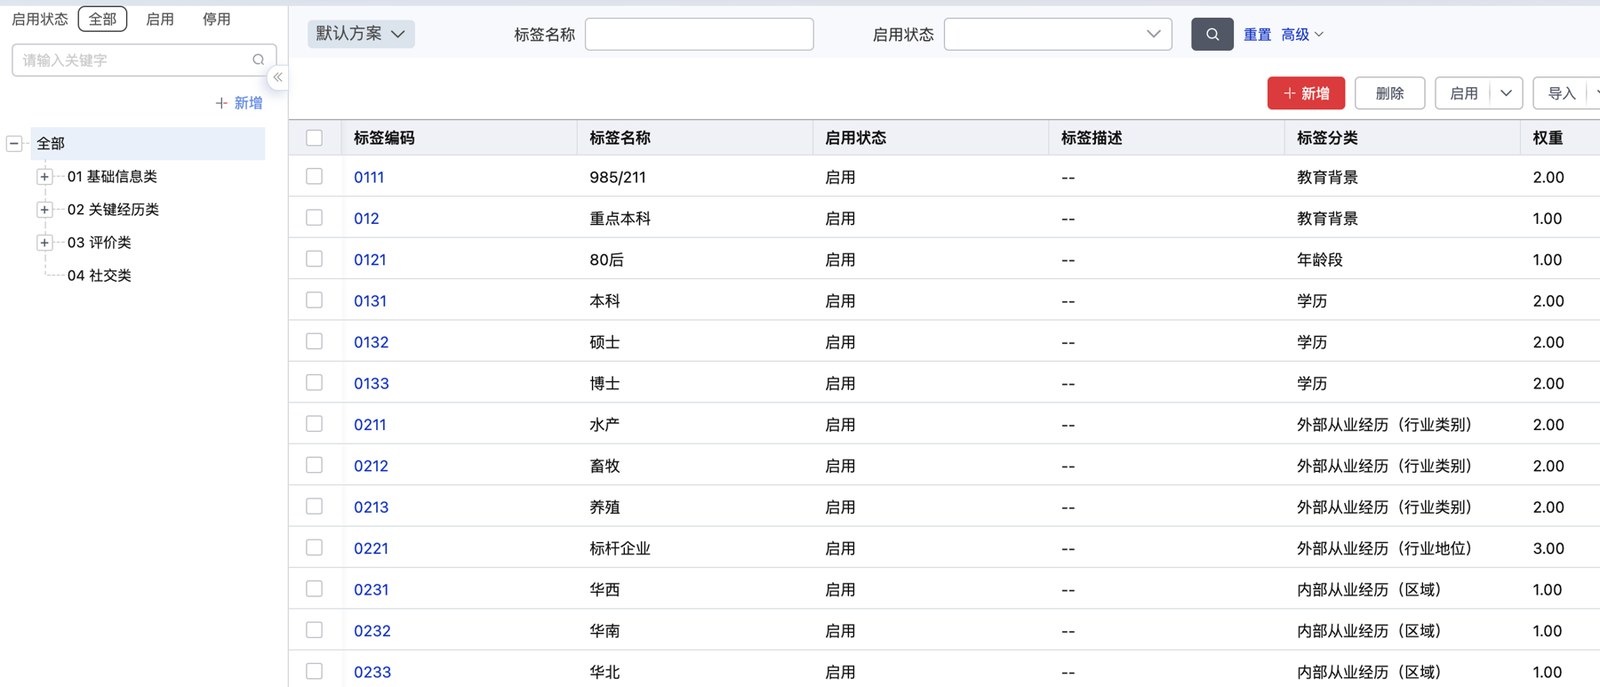
图2:人才标签库结构:标签编码、名称、启用状态、描述、分类、权重六个字段,左侧按基本信息类、关键经历类、评价类、社交类分组
聚合到组织层,判断标准也要换。个人层问"这个人怎么样",组织层问"这条线缺什么能力、缺多少人、多久能补上"。用友 BIP 人力云的人力分析把标签按组织、条线、层级聚合,输出的是能力缺口与供给节奏,不是人才排名——这才是画像能进经营会的原因。
注:本文分析基于《用友 DHR 人才发展解决方案》2026年3月版与用友官方公开信息,具体技术细节以用友 BIP 人力云产品文档为准。
高频问答
Q1:人才画像和人才盘点、胜任力模型是什么关系?
一套东西的三个环节。能力素质库定义"什么是好的",属标准层;人才盘点在标准上做横向校准,属评价层;画像把标准、证据、结论聚合到一个人身上,属档案层。三层共用一套能力项,人岗匹配与继任提名才有同一个基准。只做盘点不做画像,结论第二年就散在会议纪要里;只做画像不做盘点,画像没有横向校准,个体分数不可比。
Q2:已经有测评系统和人事档案,还要不要单独建画像?
多数不需要新建系统,要补的是统一标准与证据链。常见现状是测评一个系统、绩效一个系统、干部档案又一个,评价时靠人拼接。该做的是把三类数据口径对齐、通过接口汇聚,再让盘点与配置复用同一套标准——画像在这个意义上是一个数据视图,不是又一个产品模块。
Q3:标签谁来维护?口径打架怎么处理?
口径归 COE,字段归系统。做法是标签分级:一级分类由 COE 标签库统一管理,二级标签允许业务单元申请新增,但须挂在一级分类下并写明权重与取值规则。每次变更留痕,每半年做一次标签使用率盘点,长期没人调用、使用率低于30%的标签直接停用——标签库最怕的不是少,是没人清理。
Q4:画像上线之后,怎么判断它有没有真的被用起来?
看三个可查的痕迹:人才盘点会上有没有现场调画像、继任提名表里有没有引用画像里的结论、组织层的能力缺口分析有没有用同一套标签。三处都空着,说明画像还只是一个数据视图,没有进入任何流程。
Q5:画像里的评分能不能让 AI 自动生成?
可以把360评语、项目复盘这类非结构化材料做语义理解与实体抽取,抽成可追溯的结构化证据;但结论要由人签字。AI 能做的是把证据找全、把互相矛盾的证据标出来,不是替人下判断——高风险的人事决定留人工复核,这条边界不能因为模型变强就松动。
本文核心观点
1. 画像的价值不在标签数量,而在它是否被至少一个真实决策消费过;没被消费的画像等于一份排版更好的档案。
2. 对标颗粒度决定画像成色:比任职资格只能筛"能不能进",比能力项与行为等级才能判断"能做多好"。
3. 潜力不能用绩效外推:绩效看达成,潜力看迁移与学习曲线,证据源不同,混用会让九宫格里"明星"与"高潜"合流。
4. 落地顺序是标准、证据、模型,反序只会得到一套更精致的排序,评审会照样不签字。