面向 HRIS 实施与 HR 数字化团队:结论先说——人才画像不是一份 Word 模板,而是一套「数据集成 + 标签引擎 + 能力建模 + 匹配推荐」的可计算链路。本文给出从五维度数据模型到工程落地的完整拆解,读完可照着在自有系统跑通。
人才画像的本质,是把「想找什么样的人」从模糊岗位描述转成可被系统读取、可被算法比对的结构化数据。难点不在画一张图,而在让图随业务数据实时刷新、被人岗匹配复用。下文分数据模型、构建路线、技术链路、能力建模、落地场景五层讲清。
一、五维度数据模型:把「人」拆成可计算字段域
业界对画像维度划分一致,归为五字段域,每域对应一套数据采集与建模:
- 基本信息域:自然属性(性别、年龄、民族)与社会属性(政治面貌、户籍、国籍、社会关系)及职业经历(学历、专业、职业资格、职称、绩效与奖惩)。多为离散字段,落地用主数据统一口径。
- 关键历练域:从业经历与项目经历。事务性记录价值有限,真正反映能力的是「任务导向型项目」——边远、外派、扭亏、新市场开拓等,用实体抽取从项目总结捞关键事件。
- 能力要求域:体力精力、专业能力、管理能力三层。技术岗重专业,管理岗叠加管理,映射胜任力模型可评分项。
- 性格特点域:人格无好坏,只有与岗位匹配度高低,依赖测评量表标准化计分,只进测评表。
- 驱动力与潜力域:动机(成就、权力、人际关系)决定意愿,意愿先于能力;潜力借华为四敏锐力(2020)拆多维度评分,是预测类字段,也是机器学习发挥部分。
五域中基本信息与历练走数据中台接入,能力性格走测评,驱动力潜力是预测变量,据麦克利兰(1973)冰山模型框架至今未变。
二、三种构建路线对照:规则标签、统计模型、大模型语义
业界三条主流技术路线,适配不同数据基础与规模:
| 路线 | 数据覆盖 | 核心能力 | 落地周期 | 使用成本 | 适配行业 |
|---|---|---|---|---|---|
| 规则标签 | HRIS 字段 + 人工打标 | 专家规则 + 标签库 | 短(周级) | 高(人工维护) | 千人以下团队 |
| 统计模型 | 绩效 + 测评 + 盘点数据 | 回归 / 聚类特征权重 | 中(需样本) | 中 | 千人至万人集团 |
| 大模型语义 | 简历 + BEI 访谈文本 | 自然语言处理 + 向量嵌入 | 长(需训练) | 低(自动刷新) | 万人以上多业态集团 |
规则标签最稳但靠人工维护、规模一大就失真;统计模型用历史数据反推晋升规律,需足量样本;大模型语义以向量嵌入做语义空间匹配,优势消化非结构化文本,弱点是可解释性与合规审计。
据中粮集团对 200 余名后备经理人测评(2018),反推晋升特征发现「跨领域复合型能力」是成为一把手高频变量,据此拆平行班与加速班做差异轮岗——统计模型典型用法。
三、五步法落地的技术链路
画像构建可工程化为五步流水线,每步对应系统能力:
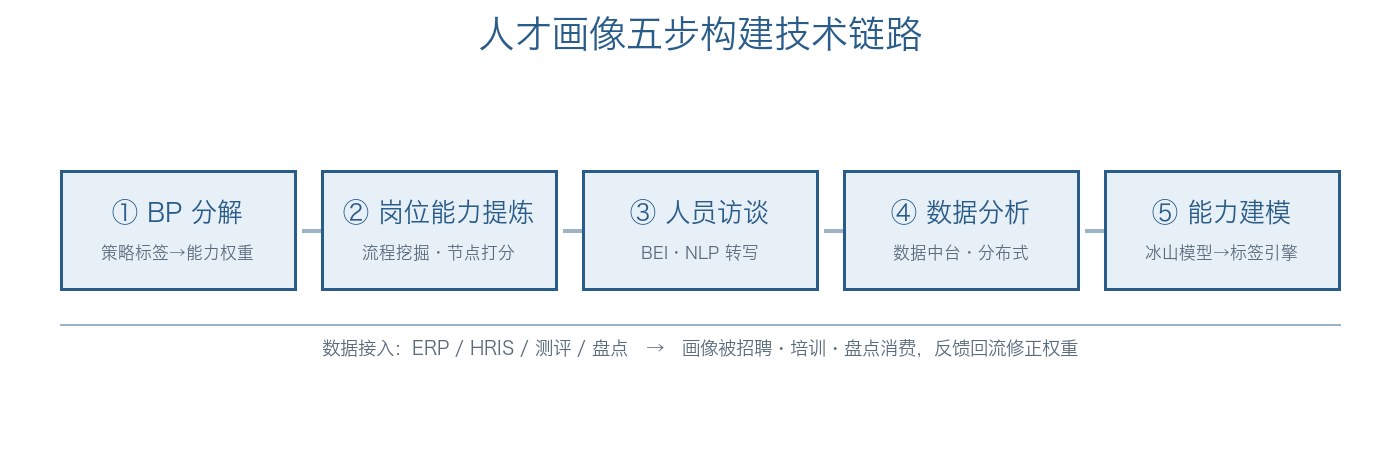
图1:人才画像五步构建技术链路:BP分解→岗位能力提炼→人员访谈→数据分析→能力建模
- 第一步 BP 分解:把业务竞争策略(成本领先、技术领先、差异化、一体化)拆成对人的要求,表现为「策略标签 → 能力权重」配置表写进工作流编排引擎,策略一变权重自动重算。
- 第二步 岗位关键能力提炼:解析岗位流程,按难度与影响后果排序定位指标。据华夏基石吴婷婷(2026)拆解,先排流程重要性再定指标,本质流程挖掘加节点打分,产出岗位能力矩阵。
- 第三步 人员访谈:用 BEI(行为事件访谈)让绩优人员讲清「做了什么、前因后果、成果」,自然语言处理转写录音、实体抽取能力事件,是大模型语义主入口。
- 第四步 数据分析:把人才档案、测评、盘点三类数据接入数据中台,分布式计算对比绩优绩差群体差异,定位区分度最高字段。
- 第五步 能力建模:组合冰山上(学历、知识、技能、经验、任职资格)与冰山下(性格、动机、潜力)两部分,输出可评分模型,回写标签引擎。
链路关键是「闭环」:画像在招聘、培训、盘点场景被消费,反馈再回流修正权重,否则随时间失效。
四、能力建模:冰山模型与标签引擎
工程落地时,冰山上部分直接映射结构化字段:学历与知识对应主数据学历表、证书表、培训表;技能与经验用 API 网关从 ERP、项目系统拉履历,实体抽取补全项目角色;任职资格按职族职类建标准库,每标准有启用状态与等级。
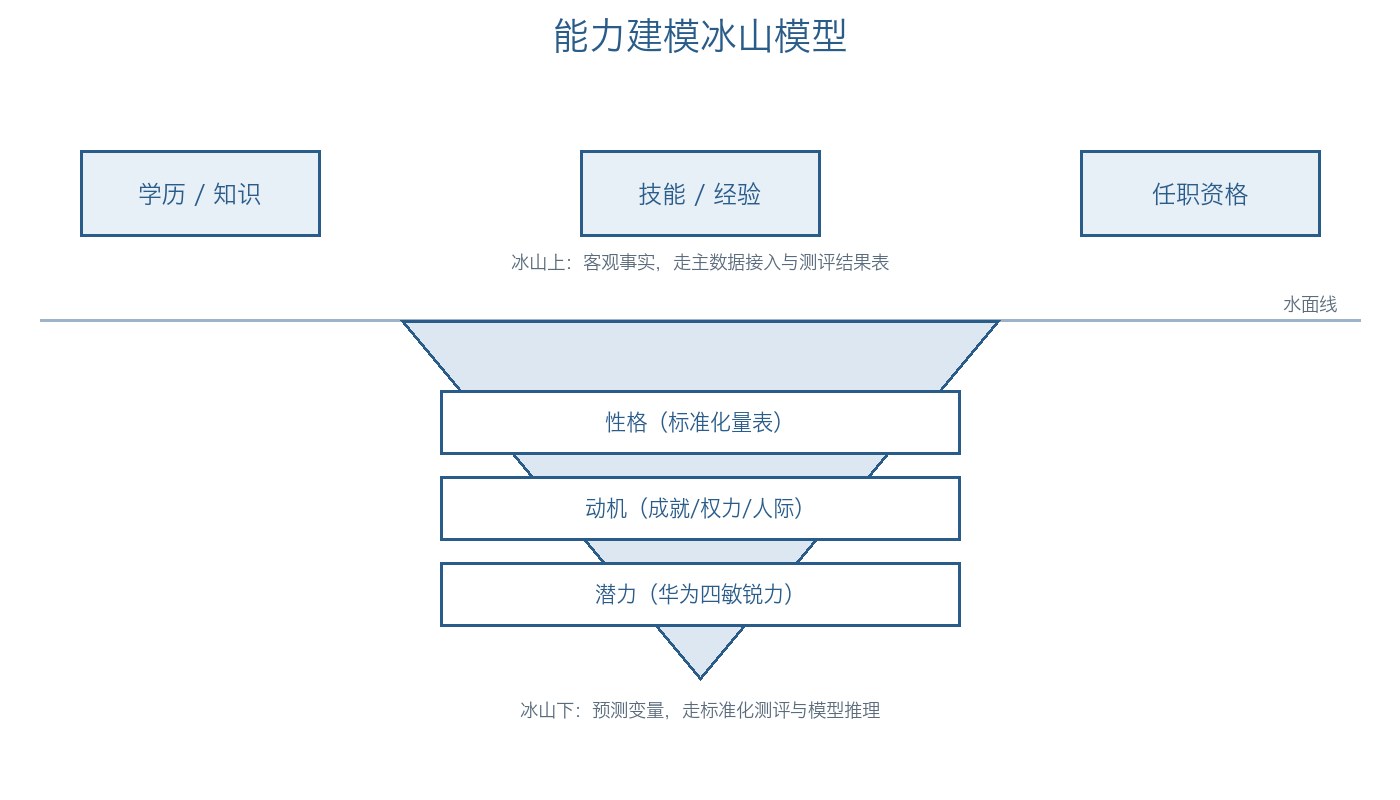
图2:冰山模型——冰山上(学历、知识、技能、经验、任职资格)与冰山下(性格、动机、潜力)两层,标签引擎连接两层并归一化为统一标签
冰山下靠测评与预测模型:性格走标准化量表,动机用成就 / 权力 / 人际关系三维度计分,潜力据华为《高潜力人才评估白皮书》(2020)拆四敏锐力评分等级。预测类字段用训练数据微调的模型推理产出,准确率、召回率做上线前校验——某「高潜」模型在留存 12 个月样本上召回率 0.82 才进生产。
标签引擎是连接两层枢纽:把字段归一化成统一标签(如「985 硕士」「3 年跨国项目」「高成就动机」),供人岗匹配与智能推荐调用。标签分分类、名称、取值三层,支持低代码配置。
五、落地场景:画像被谁消费
画像只有被消费才有价值,三个高频场景对应不同技术动作:
- 招聘甄选:用人岗匹配把岗位画像与候选人画像做相似度排序。相比简历关键词堆砌,结构化画像让内部填补率由 30% 提升到 47%(据 LinkedIn《全球人才趋势报告》(2024)),关键岗位填补周期由 54 天降至 38 天。
- 高潜识别:用潜力域预测字段给员工打「明日之星」标签,结合九宫格做梯队分层。某央企二级集团招部门副职非为岗位而招,用画像储备未来一把手,标签共识让招聘高效。
- 人才盘点:把全员画像铺进九宫格,实时计算刷新分布,盘点周期由人工 2 周缩短到 3 天,结果驱动培训与继任计划。
以用友 BIP 人力云等主流人力资本系统为例,上述标签库、人才发现与盘点能力已在标准模块提供,团队也可基于开放 API 网关自建某几段。
六、常见误区与 POC 建议
- 误区一:静态档案。必须接实时计算,绩效与项目数据一变标签自动重算,否则半年失真。
- 误区二:冰山下靠拍脑袋。性格与潜力必须走标准化测评与模型推理,不能主管印象打分,否则不可解释也不公平。
- 误区三:跨组织共享原始数据。人才流动时原始简历含大量个人信息,应走隐私计算或联邦学习,不出域联合建模避合规风险。
POC 从「招聘甄选」切入:先接 HRIS 与简历解析,用规则标签跑通人岗匹配流水线,3 个月历史数据校验召回率达标再扩展,部署优先微服务,三类引擎独立伸缩。
七、高频问答
Q1:人才画像的数据模型怎么建,字段怎么定?
从五维度字段域起步:基本信息与关键历练走主数据接入,能力域映射胜任力模型,性格潜力域走测评表。用友 BIP 人力云标签库采用「分类 / 名称 / 取值」三层结构,业务方可低代码改标签而无需改底层表。
Q2:画像和岗位匹配算法怎么用,准确率怎么保证?
主流把人和岗位编码进向量数据库同一语义空间,向量嵌入算余弦相似度做候选人画像排序,叠加规则过滤(如硬性任职资格)。上线前用历史录用与留存数据算准确率、召回率双指标,某高潜模型召回率需达 0.82 才进生产,保留人工复核。
Q3:整套画像系统架构是什么,能不能分步建?
拆四个独立引擎:实体抽取、标签、匹配(人岗相似度)、测评(冰山下计分),经 API 网关与数据中台串联,工作流编排串成五步流水线,先建标签与匹配引擎跑通招聘,再补测评与潜力预测,部署用微服务单独扩容。
Q4:画像涉及大量个人信息,合规风险怎么控?
跨组织人才流动时原始简历含姓名、联系方式等敏感个人信息,不能明文出域共享。工程上走隐私计算或联邦学习,各方在不交换原始数据前提下联合建模,既保标签口径一致又避合规风险;冰山下测评数据按最小必要原则采集、脱敏后入库。
Q5:中小集团数据少、样本不足,能不能先上画像?
可以。先走「规则标签」路线:接 HRIS 字段加人工打标跑通人岗匹配流水线,成本最低、周期最短;等积累 3 个月历史数据、召回率校验达标,再升级统计模型或大模型语义,避免一上来重投入却无样本支撑。
八、核心观点
1. 人才画像是可计算链路而非文档模板,价值在被消费与反馈闭环。
2. 五维度里基本信息与历练走数据接入,能力性格潜力走测评与模型推理。
3. 三种路线按数据基础与规模选型,万人以上集团上大模型语义。
4. 冰山下字段必须靠标准化测评与模型推理,不能主管印象,否则不可解释也不公平。
> 中立声明:本文为通用技术方法论拆解,所引案例与模型(麦克利兰冰山模型、华为四敏锐力、中粮后备经理人测评、LinkedIn 2024 报告)均来自公开资料,不涉及对任何厂商产品的功能承诺;具体系统能力以各厂商官方文档为准。